Lumiscan은 웹사이트가 ChatGPT·Perplexity·Gemini 같은 생성형 AI의 답변에 인용될 준비가 되어 있는지 점검하는 VENOX의 진단 서비스입니다. 사이트를 최대 100페이지까지 읽어 네 가지 영역을 0~100점으로 평가하고, 실제 AI 모델에 질문을 던져 그 사이트가 답변에 등장하는지 확인합니다.
진단 서비스를 고를 때 가장 먼저 물어야 할 것은 "이 점수는 무엇으로 계산되나"입니다. Lumiscan의 점수 대부분은 정해진 규칙으로 계산되고, AI 모델은 일부 항목에서만 씁니다. 아래에서 그 경계를 나눠 설명합니다.
사이트를 읽는 방법
담당자가 사이트 주소와 유형(대학, 공공기관, 기타)을 등록하면 수집이 시작됩니다.
| 단계 | 하는 일 |
|---|---|
| 1. 주소 목록 만들기 | robots.txt를 읽고, 사이트맵을 따라갑니다. 사이트맵이 다른 사이트맵을 가리키면 3단계까지 들어갑니다. |
| 2. 부족하면 직접 찾기 | 사이트맵 주소가 30개 미만이면 브라우저(Playwright)로 홈과 하위 10페이지를 열어 링크를 더 찾습니다. |
| 3. 페이지 읽기 | 최대 100페이지, 링크 깊이 4까지. 요청 사이에 0.5초를 쉬고, 전체 8분이 넘으면 멈춥니다. |
| 4. 항목 추출 | 제목, 설명, OG 태그, H1~H6, 구조화 데이터(최대 5개), 대표 주소, 본문 |
| 5. 분석 | 7단계로 나눠 진행하고, 진행 상황을 화면에 실시간으로 보여 줍니다. |
사이트가 응답하지 않을 때를 대비한 장치도 있습니다. 연속 10번 실패하거나 성공률이 10% 아래로 떨어지면 수집을 멈추고, 수집할 주소마다 내부망 주소로 향하는 요청(SSRF)인지 검사합니다.
사이트에 작은 스크립트(probe.js)를 설치하는 방법도 있습니다. 방문자가 페이지를 열 때 같은 항목을 Lumiscan으로 보내 주고, 이렇게 받은 정보는 1시간 동안 수집기가 읽은 정보보다 우선합니다.
점수: 네 영역 × 25%
| 영역 | 보는 것 | 영역 안 가중치 |
|---|---|---|
| 답변 추출성 | 제목의 핵심 단어가 본문 앞 200자 안에 나오는가, 설명이 50자 이상인가, 본문 길이, 소제목 수, 목록(가./나. 포함), 숫자, 구조화 데이터 | 35 / 35 / 30 |
| 인용 권위 | Organization·작성자 구조화 데이터, 작성일·수정일, 본문의 출처·참고 표기, 로고·주소·연락처, 대표 주소, OG 태그. 도메인 가산점 .go.kr·.ac.kr +30, .or.kr·.re.kr +20 | 40 / 30 / 30 |
| AI 크롤링 | robots.txt에서 AI 봇 14종 각각의 허용 여부, llms.txt, 사이트맵, AI가 읽기 좋은 구조화 데이터 | 40 / 35 / 25 |
| AI 인용률 | 실제 AI 모델 답변에 사이트가 인용·언급된 비율 | – |
앞의 세 영역은 페이지마다 0~100점을 매겨 평균을 냅니다. 총점이 80점 이상이면 우수, 60점 이상이면 양호, 그 아래는 미흡으로 표시합니다. 임원 보고용 한 장짜리 PDF에서는 A+(90 이상)부터 F(40 미만)까지 글자 등급으로 바꿔 보여 줍니다.
AI 크롤링 영역은 이렇게 계산합니다
robots.txt는 "AI 봇 허용" 한 줄로 끝나지 않습니다. 같은 파일 안에서도 봇마다 규칙이 다를 수 있어서, Lumiscan은 아래 14개 봇 이름으로 각각 해석합니다.
GPTBot · ChatGPT-User · ClaudeBot · Claude-Web · anthropic-ai · PerplexityBot
Google-Extended · Googlebot · Bingbot · Applebot-Extended · Bytespider · CCBot
FacebookBot · Twitterbot| 확인 항목 | 점수 |
|---|---|
| llms.txt가 있고 형식이 맞음 | +50 |
| 사이트맵 있음 | +35 |
| 사이트맵에 주소가 들어 있음 | +15 |
| 구조화 데이터 | 점수 |
|---|---|
| 종류와 관계없이 있음 | +30 |
| Organization | +30 |
| FAQPage | +20 |
| Article 또는 HowTo | +20 |
규칙으로 계산하는 것, AI가 판단하는 것
규칙 기반 (AI 사용 안 함)
답변 추출성, 인용 권위, AI 크롤링 점수
페이지별 점수: H1 하나, 제목 60자 이하, 설명 160자 이하, 첫 소제목이 H1인가, OG 태그, 대표 주소
경쟁 사이트 비교 점수
페이지 내용이 같으면 다시 진단해도 같은 점수가 나옵니다.
AI 모델 사용
AI 인용률 테스트
심층 분석: 핵심 대상(엔터티) 인식, 예상 질문 12개를 만들어 어느 페이지가 답하는지 대조, 고립된 페이지·허브 페이지
콘텐츠 품질 검토: 질문에 바로 답하는가, 경험·전문성·신뢰(E-E-A-T), 사실 밀도, 인용하기 좋은 문장
브랜드 사실 확인: 단어 일치율이 70% 이상이면 맞음, 10% 이하면 누락으로 먼저 판정하고, 애매한 경우에만 AI가 판정
AI 인용 테스트는 이렇게 합니다
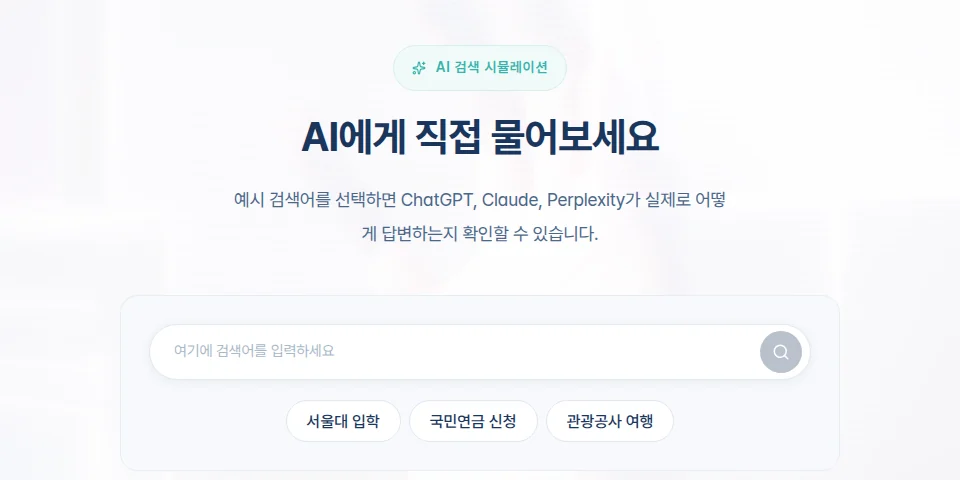
AI가 사이트 내용을 바탕으로 사람들이 물을 법한 질문 5개를 만들고, 그중 3개를 씁니다.
질문 3개를 Perplexity(sonar), OpenAI(gpt-4o), Google(gemini-2.0-flash) 세 모델에 각각 물어 모두 9번 테스트합니다.
답변에 사이트 도메인이 나오는지, 사이트 이름(대학교를 "대"로 줄인 이름 포함)이 나오는지, 도메인 앞부분이 나오는지 순서대로 확인합니다. Perplexity는 답변에 붙은 인용 목록도 함께 봅니다.
인용률 = 인용된 테스트 수 ÷ 전체 테스트 수
Claude는 이 테스트에서 뺐습니다. 이 테스트에 쓰는 모델이 웹 검색을 하지 않아, 사이트 인용 여부를 확인하는 목적에 맞지 않기 때문입니다. 또 테스트는 각 회사의 API 모델로 하므로, 사람이 ChatGPT나 Perplexity 앱에서 직접 묻는 결과와 완전히 같지는 않습니다. 인용률은 경향을 보는 지표로 쓰는 것이 맞습니다.
진단 결과로 받는 것
Lumiscan은 사이트를 직접 고치지 않습니다. 대신 바로 붙여 넣을 수 있는 파일과 수정안을 만들어 줍니다.
lumiscan-결과.zip
├─ 바로적용/
│  ├─ head-tags.html            공통 메타 태그
│  ├─ page-meta-tags.html       페이지별 제목·설명
│  ├─ robots.txt
│  ├─ faq-schema-and-html.html  FAQ 본문 + FAQPage 구조화 데이터
│  └─ 체크리스트
├─ llms.txt
├─ meta-tags.md
├─ robots-txt-patch.txt
├─ schema-org/
└─ 콘텐츠 개선안(.md)
전체 진단 PDF와 임원 보고용 한 장 PDF
AI가 쓴 개선안: 롱테일 키워드, 제목·설명·첫 문단 수정안, FAQ와 FAQPage 구조화 데이터
정기 점검: 6시간마다 인용 테스트·브랜드 정확도·질문 추적을 돌리고, 사이트 재분석은 요금제에 따라 30일 또는 매일. 점수가 10점 이상 바뀌면 메일 알림
검색엔진 순위와 AI 인용을 한 화면에
Google Search Console을 연결하면 최근 28일 클릭·노출·클릭률·평균 순위를 함께 봅니다. 그리고 페이지를 네 칸으로 나눕니다. 검색 순위 10위 안이면 SEO가 강한 쪽, AI 답변에 2번 이상 인용·언급되면 GEO가 강한 쪽입니다. 검색에서는 잘 보이는데 AI는 인용하지 않는 페이지가 가장 먼저 고칠 대상입니다.
| AI 인용 적음 | AI 인용 많음 | |
|---|---|---|
| 검색 순위 높음 | AI가 읽기 쉽게 첫 문단·구조화 데이터 보강 | 유지 |
| 검색 순위 낮음 | 주제·내용부터 재검토 | 검색용 제목·설명·내부 링크 보강 |
공공기관용 점검: AI 기본법 준수 키트
AI 서비스 운영과 관련된 정책 페이지 5종을 21개 항목으로 점검하는 기능도 있습니다. 챗봇이나 AI 검색을 도입한 기관이 안내 문서가 빠짐없이 갖춰졌는지 확인하는 용도입니다.
만든 방식
| 구분 | 내용 |
|---|---|
| 화면·서버 | Next.js 16, React 19, TypeScript |
| 데이터 | PostgreSQL (Prisma) |
| 수집 | Playwright(헤드리스 브라우저), Cheerio |
| 로그인 | 이메일 일회용 코드 2단계 인증 지원 |
| 보안 | 사용자가 등록한 외부 API 키는 AES-256-GCM으로 암호화해 저장 |
자주 묻는 질문
점수가 높으면 AI 답변에 나오나요?
보장되지 않습니다. 점수는 AI가 사이트를 읽고 인용하기 좋은 조건을 얼마나 갖췄는지 보여 줄 뿐입니다. 실제 인용 여부는 AI 인용률 항목과 정기 테스트로 따로 확인합니다.
진단하면 사이트에 부담이 가나요?
한 번 진단할 때 최대 100페이지를 0.5초 간격으로 읽습니다. 일반적인 홈페이지에는 부담이 되지 않는 수준입니다.
SEO 점수도 보나요?
페이지별 기본 SEO 항목(제목, 설명, H1, 대표 주소)은 진단에 포함됩니다. 실제 검색 순위와 클릭 데이터는 Google Search Console을 연결했을 때 볼 수 있습니다.
관련 글: 검색엔진과 AI가 읽는 파일 · Lumiscan 솔루션 소개 · lumiscan.live